※本記事は、投資判断や個別銘柄の推奨を目的としたものではありません。株価や業績、市場シェアに関する情報は執筆時点のものであり、状況は日々変化します。投資の最終判断は、必ずご自身の責任において行っていただきますようお願いいたします。
「メモリ」だけで、こんなに種類があるとは
前回の第2回「AI最大の壁はデータセンターだった!電力不足がAIの未来を左右する理由」では、AIが電力・冷却・送電網という壁にぶつかっていることを見てきました。
そして最後にお伝えした通り、電力の話をひも解いていくと、必ずもう一つの主役に行き着きます。
メモリとストレージです。
私は最初、「メモリって、パソコンの中に入っているアレでしょう?」くらいの理解しかありませんでした。
けれど調べていくと、AIの世界では「DRAM」「NAND」「HBM」という3つの言葉が、まったく違う役割を持って登場することが分かってきました。
さらに、キオクシアやSK hynixといった企業が、それぞれ違う立ち位置でこの3つに関わっていることも分かってきました。
今回は、この3つのメモリの違いを、身近なたとえを使って整理していきたいと思います。
まずは全体の位置関係から
いきなり細かい話に入る前に、3つがどういう関係にあるのかを確認しておきましょう。
メモリ・ストレージ
 ├ DRAM(作業机)……計算中のデータを一時的に置く
 ├ NAND(倉庫)………データを長期的に保存する
 └ HBM(特急の作業机)…GPUのすぐ隣で超高速にデータを渡す
今日はこの3つが「それぞれ何をしているのか」「なぜ投資家に注目されているのか」を理解していただければと思います。
DRAMとNAND ― おさらいは簡単に
DRAMとNANDについては、第1回の「AIブームは本当に続く?半導体だけでは語れないAIの仕組み」で、作業机と倉庫のたとえを使ってお話ししました。
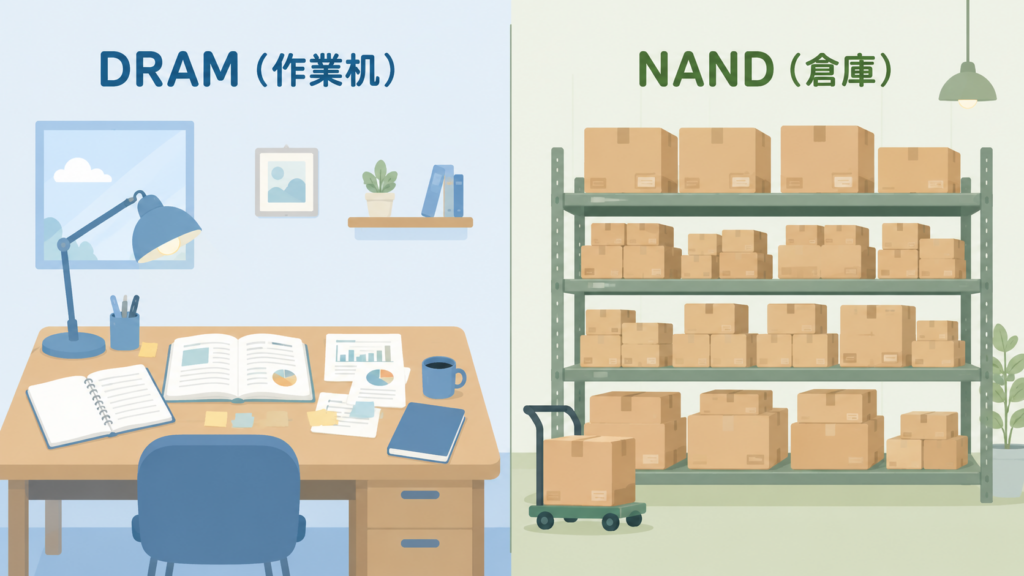
簡単におさらいすると、DRAM(作業机)は計算中のデータを一時的に置く場所、NAND(倉庫)はデータを長期的に保存する場所でした。電源を切ると机の上のデータは消えますが、倉庫の中身は消えません。
生成AIが普及するにつれて、この倉庫(NAND)の重要性も急速に高まっています。AIサーバーは膨大な学習データをひっきりなしに倉庫から取り出しては使う、という作業を繰り返しているためです。
今回、じっくり掘り下げたいのは、この2つよりも少し複雑な立ち位置にある「HBM」です。
HBMとは ― なぜAIに「専用のメモリ」が必要になったのか
ここまでの2つに比べて、聞き慣れない方が多いのが「HBM(High Bandwidth Memory/高帯域幅メモリ)」だと思います。
結論から言うと、HBMは「DRAMの一種」です。ただし、普通のDRAMとは置かれている場所も、作り方もまったく違います。
「メモリの壁」という問題
そもそも、なぜHBMのような特別なメモリが必要になったのでしょうか。
GPUの計算能力は年々進化しています。しかし、いくらGPUが速く計算できても、メモリからデータを受け取るスピードが追いつかなければ、GPUは「データ待ち」の状態になってしまいます。この問題は「メモリの壁」と呼ばれているようです。AIアクセラレータでは、メモリ帯域幅の成長が計算能力の成長に遅れをとる「メモリの壁」が、アクセラレータが計算リソースをどれだけ効果的に活用できるかを制約しています。
特に生成AIは、この壁の影響を受けやすい仕組みになっているようです。大規模言語モデルは推論中にメモリ律速の特性を示し、文章を1文字生成するたびに、これまでの会話内容全体に何度もアクセスする必要があります。つまり、GPUの計算力をフルに引き出すには、メモリ側の「データを渡すスピード」を上げるしかありません。この課題への回答として生まれたのがHBMです。
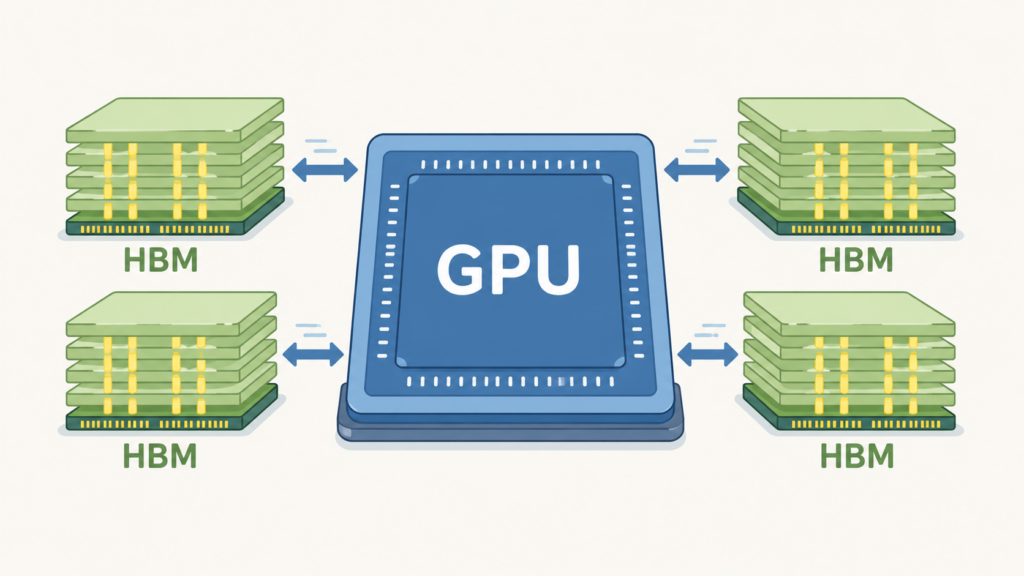
図にすると、DRAMとHBMの違いは次のようなイメージです。
【従来のDRAM】
GPU  ―――(距離が遠い)――― DRAM
     ↓
   待ち時間が発生

【HBM】
GPU ■■ HBM(すぐ隣)
     ↓
   高速にデータが届く

縦に積む・横に並べる・近くに置く
HBMの構造は、よく「縦に積む・横に並べる・近くに置く」という3つのアイデアの組み合わせだと説明されます。
まず「縦に積む」。HBMは極薄のDRAMダイを何層にも積層し、数千本ものシリコン貫通ビア(TSV)で垂直につなぐ構造になっています。1枚1枚は薄い紙のようなチップを、何層も重ねたビルのようなイメージです。
次に「横に並べる」。この積み重なったチップの塔を、複数本並べて土台の上に配置します。そして「近くに置く」。この土台ごと、GPUのすぐ隣にぴったりと配置します。距離が近いほど、データのやり取りにかかる時間が短くなるためです。
この3つの工夫によって、通常のメモリとは桁違いの帯域幅が実現されています。一般的なDDR5に比べ、幅広いバス(1024ビット以上)と短い配線によって超高帯域幅を実現しており、NVIDIA・AMDのGPUやGoogleのTPUなどに採用されています。
世代ごとに進化するHBM
HBMは現在も進化を続けており、世代によって性能が大きく変わります。
| 世代 | 発表時期 | 主な特徴 | 帯域幅の目安 |
|---|---|---|---|
| HBM3 | 2022年1月 | JEDECが規格を発表 | 約819GB/s |
| HBM3E | HBM3の改良版 | 最大12〜16層スタック、36〜48GB容量 | 1.2TB/s超 |
| HBM4 | 2025年4月 | 入出力ピンが1,024→2,048へ倍増 | 2TB/s超 |
HBM3Eは最大12層のDRAMスタックに対応し最大36GBの容量を実現、16層スタックでは48GBの容量を持つ製品も登場しています。そして次の世代であるHBM4では、入出力ピン数がHBM3Eまでの1,024から2,048へと倍増し、入出力帯域幅が約1.5倍に拡大する見込みです。
HBM4での変化は、単純な「スピードアップ」だけではないようです。HBM4ではロジックベースダイが最先端のロジックプロセスで製造されるようになり、メモリ内部でのデータ処理能力が向上します。これによって、データをGPUに送らずメモリ内で処理する「メモリ近傍演算」の実現に近づいています。将来的には、メモリそのものが「考える」役割の一部を担うようになるかもしれない、というわけです。
━━━━━━━━━━━━
ここまでが「HBMって何?」でした。
ここからは「なぜHBMが高いのか」を見ていきます。
━━━━━━━━━━━━
なぜHBMは、世界で3社しか作れないのか
HBMがこれほど話題になる理由の一つは、製造の難しさにあります。
HBMのアーキテクチャーでは極薄のDRAMダイを積層し、数千本のシリコン貫通ビアで接続する垂直設計を採用しており、より高い製造精度が求められるため、HBMは製造が特に難しいメモリ製品の1つとなっています。具体的には、直径5〜8マイクロメートル・深さ30〜50マイクロメートルという極めて微細なTSVの高精度形成、厚さ30〜50マイクロメートルまで薄くしたウエハーの繊細なハンドリング、そして複数のダイを積み重ねる際の精密な位置合わせが、最も難しい工程とされています。
こうした技術的なハードルの高さもあり、HBMを量産できる企業は、世界にSKハイニックス・Samsung・Micronの3社のみとされています。
ここで気づくのが、この3社の中に「DRAMを作っている会社」しか入っていないという点です。HBMはあくまでDRAMを積み重ねた製品なので、そもそもDRAMを作っていない企業は、HBM市場に参入しようがありません。
これは、後ほど触れるキオクシアの立ち位置を理解するうえでも、重要なポイントになります。
3つを比較すると
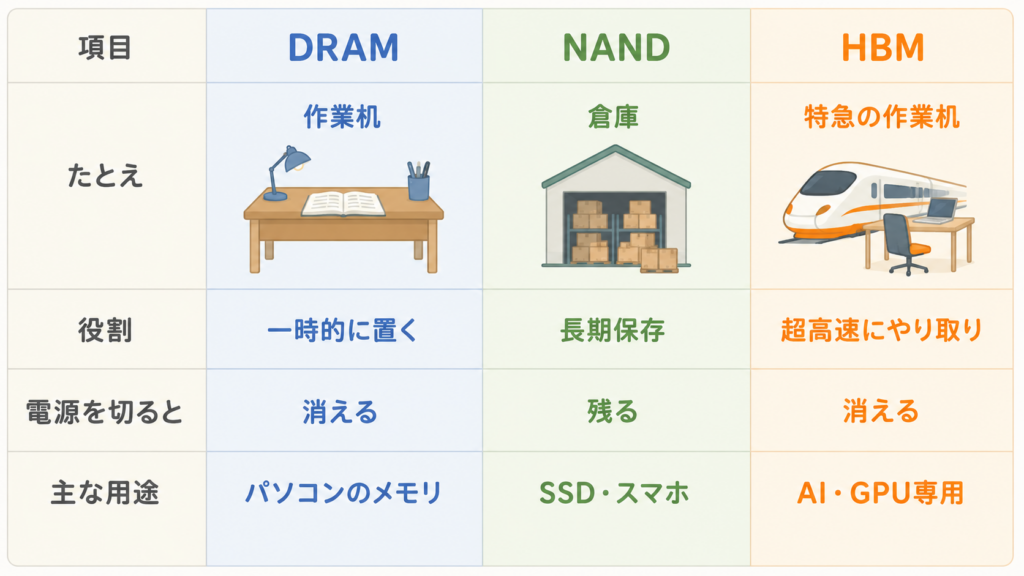
ここまでの内容を、簡単な表で整理してみます。
| 項目 | DRAM | NAND | HBM |
|---|---|---|---|
| たとえ | 作業机 | 倉庫 | 特急の作業机 |
| 役割 | 計算中のデータを一時的に置く | データを長期的に保存する | GPUのすぐ隣で超高速にやり取りする |
| 電源を切ると | データは消える | データは残る | データは消える(DRAMの一種のため) |
| 主な用途 | パソコンのメモリ | SSD・スマホのストレージ | AI・GPU専用の高性能メモリ |
なるほど、こう繋がっていたのか
実はこの3つ、単純に「別々の部品」として存在しているわけではありません。ここに、価格高騰の大きな理由が隠れています。
HBMもDDR5(一般的なDRAM)も、実は同じDRAMのウエハーから作られています。メーカーは、限られた生産能力を「HBM向け」と「一般向けDRAM」のどちらに振り向けるかを、常に選ばなければなりません。
そして、HBM1スタックの単価は、一般的なDDR5モジュールの5〜10倍以上にもなります。同じ生産設備を使うなら、メーカーとしてはHBM向けに回した方が儲かります。
その結果、一般向けのDRAM(パソコンやスマホに使われるメモリ)の生産量が構造的に減り、価格が跳ね上がる――という連鎖が起きているようです。
限られたDRAM生産能力
 ↓
HBMの方が単価が5〜10倍高い
 ↓
メーカーはHBM生産を優先
 ↓
一般向けDRAMが品薄に
 ↓
DRAM価格が全体的に高騰
「AIサーバー向けの部品が値上がりする」という話が、まわりまわって「私たちが買うパソコンやスマホの値段」にも影響している――そう考えると、少し身近な話に感じられないでしょうか。実際、DRAMの契約価格は2025年第3四半期に前年比171.8%上昇し、消費者向けメモリも2〜3倍に高騰したと報じられています。
キオクシア・SK hynix・Samsungの役割
ここからは、この3つのメモリを実際に作っている企業の話です(個別銘柄への投資を推奨するものではなく、あくまで役割の整理としてお読みください)。
まず、どの企業がどのメモリを手がけているのか、一覧にしておきます。
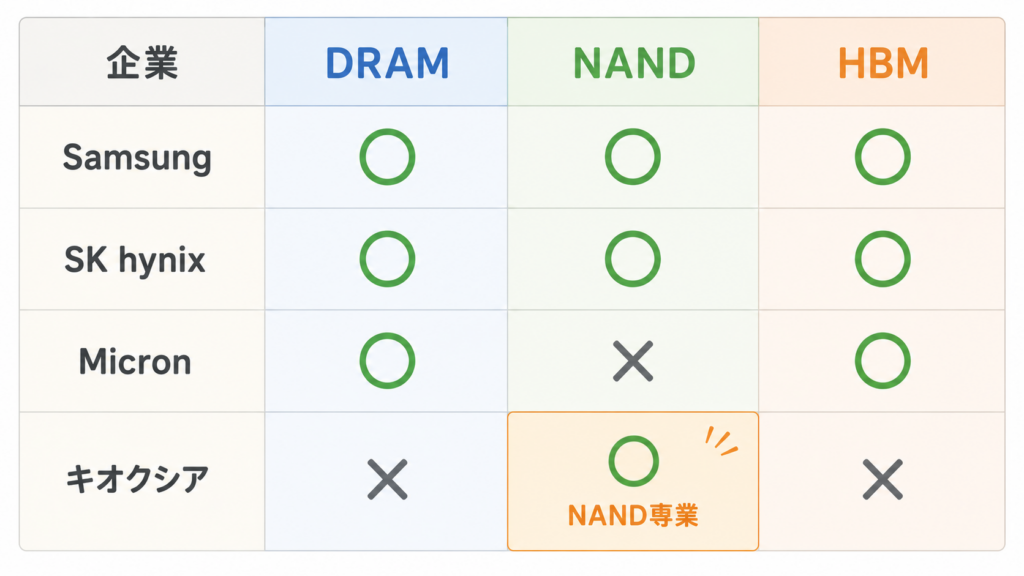
こうして並べてみると、キオクシアだけが「NANDのみ」という、はっきり異なる立ち位置にいることが分かります。
SK hynix ― HBMの王者
HBM市場で圧倒的な存在感を持つのが、韓国のSK hynixです。2026年第1四半期時点で、SK hynixのHBM市場シェアは58%に達しており、SamsungとMicronがそれぞれ21%で続いています。
NVIDIAへのHBM供給でも中心的な役割を担っているとされ、AI向け高性能メモリの分野では、当面この優位性が続くと見る専門家も多いようです。
Samsung ― DRAM・NAND・HBMのフルラインナップ
Samsungは、DRAM・NAND・HBMのすべてを手がける、数少ない総合メーカーです。
HBMでは近年SK hynixに後れを取っていた時期もあったようですが、2026年末までにHBMの生産能力を約50%引き上げる計画を進めており、巻き返しを図っている段階のようです。
キオクシア ― NAND専業という個性
日本企業として存在感を放っているのが、キオクシアホールディングスです。
キオクシアの特徴は、DRAMやHBMを持たず、NAND型フラッシュメモリだけに特化している点です。NAND型フラッシュメモリの世界シェアは3位前後で、約15〜16%を占めています。1位はSamsungで約30%、2位はSK hynixで約21〜22%です。
先ほど触れた「HBMを量産できるのは世界に3社だけ」という話を思い出してください。その3社はいずれもDRAMメーカーであり、そもそもDRAMを作っていないキオクシアは、この土俵には立っていません。つまりキオクシアは「HBM競争に出遅れている」のではなく、事業構造として最初からNAND一本に絞っている企業だといえそうです。
そもそもNAND型フラッシュメモリは、1987年にキオクシア(当時の東芝)が世界で初めて発明した技術とされています。発明者としての技術的な蓄積が、現在の競争力の土台になっているようです。
NAND専業であることは、裏を返せば「AIサーバーの計算そのもの」には直接関わらないという弱みにもなり得ます。しかし現在のAIブームでは、この弱みがむしろ強みとして働いているようです。キオクシアの業績を押し上げているのは人工知能(AI)特需であり、同社が手掛けるNAND型フラッシュメモリはデータを長期記憶する用途として、AIデータセンターへ巨額投資する米テック大手を中心に需要が集中しています。
競合各社がHBMの開発・増産に経営資源を割く中、NAND一本に集中してきたキオクシアが、データセンター向けSSD需要の急増という追い風を受けやすい立場にある――という見方もできそうです。
私自身は、「AI=GPU」というイメージだけで見ていると、キオクシアのような企業の存在に気づきにくいと感じました。メモリという切り口から見ることで、AI関連株の裾野の広さを実感しています。
今日のまとめ
- ✓ DRAM=作業机(計算中のデータを一時的に置く)
- ✓ NAND=倉庫(データを長期的に保存する)
- ✓ HBM=GPU専用の超高速作業机(メモリの壁を突破する仕組み)
- ✓ HBMはDRAMの仲間(同じウエハーを奪い合っている)
- ✓ キオクシアはNAND専業(DRAM・HBMには参入していない)
次回予告
ここまで、DRAM・NAND・HBMという3つのメモリの役割と、それを支える企業の立ち位置を見てきました。
半導体、電力、そしてメモリ。AIを支える裏側の仕組みは、ずいぶん見えてきたのではないかと思います。
けれど、まだ大事な問いが残っています。
このAIは、これからも「クラウドの向こう側」だけで動き続けるのでしょうか。
次回・第4回は、「クラウドAIとエッジAIとは?10年後のAIはどう変わるのか」というテーマです。
私たちの手元のスマホや家電の中でAIが動く時代が来るとしたら、何が変わるのか。投資家目線も交えながら、10年後を見据えて整理していきます。
私自身、「AIは全部クラウドで動いている」と思い込んでいたので、調べてみて考え方が変わったテーマです。次回もぜひお付き合いいただければ嬉しいです。